
微軟Microsoft 365全球服務在美東時間11月12日出現服務異常,且持續了30小時。周一(11/16)微軟Copilot、代理人暨平臺資深副總裁Charles Lamanna出面道歉,同時揭露內部初步調查結果,指出事故起因於一項已潛伏3個多月的程式錯誤,在網路流量增加及伺服器容量減少的雙重壓力下被觸發,進而引發全球網路閘道連鎖故障,最嚴重時有超過80%的伺服器無法回應。
微軟揭露Microsoft 365全球當機原因,潛伏3個月的程式錯誤釀禍
Posted in
業界新聞
Show the rest Hide the rest
微軟替Microsoft 365設置兩套相互獨立、架構不同的網路閘道系統,供旗下多項服務使用,以提高服務可用性。其中Exchange Online使用主要網路閘道,Teams等服務則可在兩套網路閘道之間切換,以便在其中一套發生故障時維持服務運作。
此次事故則涉及了3項因素。首先,微軟於今年7月部署一項專為Microsoft 365網路閘道設計的修正程式,卻意外引入鎖定競爭(Lock Contention)缺陷,使伺服器在特定負載下停止回應。由於測試時主要使用核心數較少、且效能較低的硬體配置,未能發現此一在新型多核心伺服器上更容易發生的問題。
其次是在事故發生前約15小時,Teams從另一套獨立網路閘道切換至同時支援Exchange Online的主要閘道,增加負載並改變了流量模式;再加上當時有約14%的網路閘道伺服器容量,因前一天的其他問題而暫停服務。
上述3項因素的疊加,導致伺服器請求大量累積並停止回應。系統原本會自動將流量轉移至正常伺服器,但這次反而使剩餘伺服器接連超載,不到兩小時便引發大規模連鎖故障。加上分區隔離機制未能發揮作用,事故最終擴散至全球。
Teams、OneDrive、SharePoint及Office應用程式因能切換至其他網路閘道而較早復原,但Exchange Online並未具備相同的切換能力,因此受到較長時間影響。
此外,微軟初期尚未掌握故障原因,嘗試讓伺服器重新上線,卻因大量積壓的請求湧入,再次觸發程式缺陷而停止回應;之後工程師雖然確認問題根源,但由於缺陷早在7月就已部署,無法透過一般版本回復機制迅速排除,只得另外開發修正程式,分批修復並重新啟動伺服器,逐步恢復服務。
微軟預計本周稍晚公布完整事故檢討報告。
Read the full article on www.ithome.com.tw
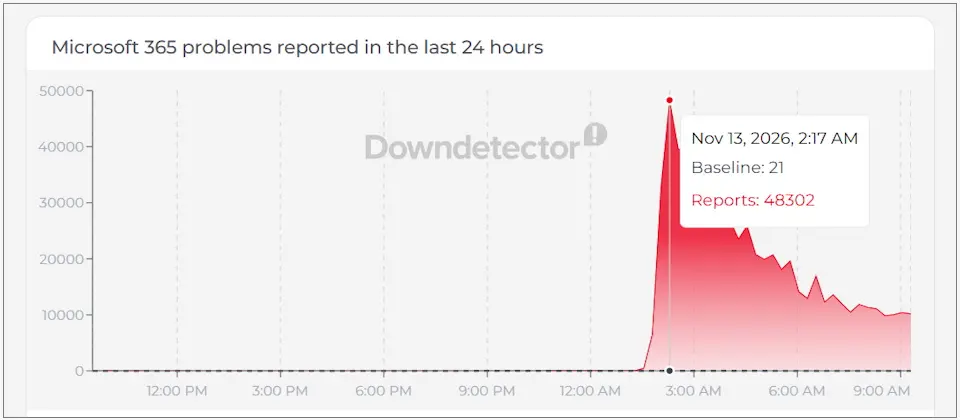
微軟Microsoft 365服務異常,影響全球多項服務
微軟Microsoft 365於美東時間11月12日發生大規模服務異常,Exchange Online、Teams、SharePoint Online及Microsoft 365 Copilot等多項服務受到影響,全球使用者可能無法正常存取
www.ithome.com.tw
Comments (0)
Sign in to comment